Qu'il s'agisse de mettre en lumière le passé ou de construire un avenir inclusif, les chercheurs d'Amii utilisent l'intelligence artificielle comme un outil puissant pour la préservation et la découverte des langues.
La langue est un outil de communication riche et puissant, utilisé à travers toutes les cultures pour transmettre des sons, des pensées, des sentiments et des idées. Elle constitue un réservoir universel et vivant de l'histoire, de la culture, de la sagesse et de l'identité humaines, et c'est l'un des éléments uniques qui font de nous tous des êtres humains à part entière.
Pourtant, à travers les siècles et les continents, une grande partie du langage humain reste soit ignorée par les infrastructures numériques modernes, soit enfermée dans des textes historiques tombés dans l'oubli.
Deux chercheurs de l’Amii s’attaquent aux deux extrémités de ce spectre linguistique à l’aide de l’intelligence artificielle. Qu’il s’agisse de garantir aux langues africaines modernes une place à l’ère de l’IA générative ou de déchiffrer de mystérieux manuscrits du XVe siècle, les projets novateurs menés par les chercheurs Ife Adebara (chercheur à l’Amii et titulaire de la chaire canadienne CIFAR en IA) et Greg Kondrak (chercheur à l’Amii) démontrent comment l’IA peut combler le fossé entre l’accessibilité numérique et l’histoire ancienne.
Renforcer les langues africaines pour l'avenir
Alors que le débat mondial porte souvent sur la productivité grâce à l'automatisation, Ife Adebara, boursière Amii, titulaire de la chaire CIFAR sur l'IA au Canada et maître de conférences à l'Université de l'Alberta, utilise l'IA pour veiller à ce que des millions de personnes ne soient pas laissées pour compte.
La plupart des outils d'IA sont entraînés sur l'anglais, le chinois et les langues européennes, ce qui laisse des millions de personnes parlant des langues africaines gravement sous-représentées. Cette fracture numérique risque d'empêcher certaines communautés de bénéficier des avancées de l'IA dans les domaines de l'éducation, de la santé et des infrastructures.
Lorsqu’une langue n’est pas prise en compte dans les données, ses locuteurs ne sont pas pris en compte dans le produit, et l’IA ne peut pas être sûre, utile ou équitable pour eux. Ils se retrouvent ainsi privés des outils linguistiques nécessaires qui pourraient faciliter la prestation de services. Cela marginalise des millions de personnes et creuse la fracture numérique.
Ife Adebara, boursière Amii et titulaire de la chaire CIFAR en IA au Canada
Pour y remédier, Adebara codirige le projet « African Next Voices », une collaboration internationale soutenue par la Fondation Gates, Meta et des institutions africaines. Comme l'explique en détail The Conversation, cette initiative vise à constituer le plus grand ensemble de données vocales en langues africaines jamais créé à ce jour pour l'intelligence artificielle.
Si nous y parvenons, l'IA intégrée dans les langues africaines ne se contentera pas de rattraper son retard. Elle établira de nouvelles normes en matière d'IA inclusive et responsable à l'échelle mondiale.
Spécialisée dans la reconnaissance vocale automatique (ASR), l'équipe collecte des données vocales issues de sources éthiques au Kenya, au Nigeria et en Afrique du Sud. Couvrant des dizaines de langues — dont l'isiZulu, le haoussa, le yoruba, le kikuyu et l'igbo —, ces échantillons variés abordent des thèmes allant des soins de santé à l'agriculture, en passant par les conversations quotidiennes.
En entraînant des modèles à traiter les dialectes parlés, Adebara jette les bases d'assistants vocaux, d'outils médicaux et de chatbots éducatifs adaptés au contexte local, permettant ainsi à chacun d'accéder à la technologie dans la langue de son quotidien.
Percer les mystères codés du passé
Alors qu'Adebara et son équipe développent des IA pour l'avenir, Greg Kondrak, chercheur Amii et professeur d'informatique à l'Université de l'Alberta, utilise la linguistique informatique pour percer les secrets cachés de l'histoire.
Environ 1 % des manuscrits historiques qui nous sont parvenus sont rédigés en code, dissimulant des secrets politiques, des lettres d’amour et des remèdes anciens. Déchiffrer ces documents à la main peut prendre toute une vie. Présenté dans *La Presse*, Kondrak exploite le traitement du langage naturel (NLP) pour percer ces énigmes cryptographiques en quelques minutes.
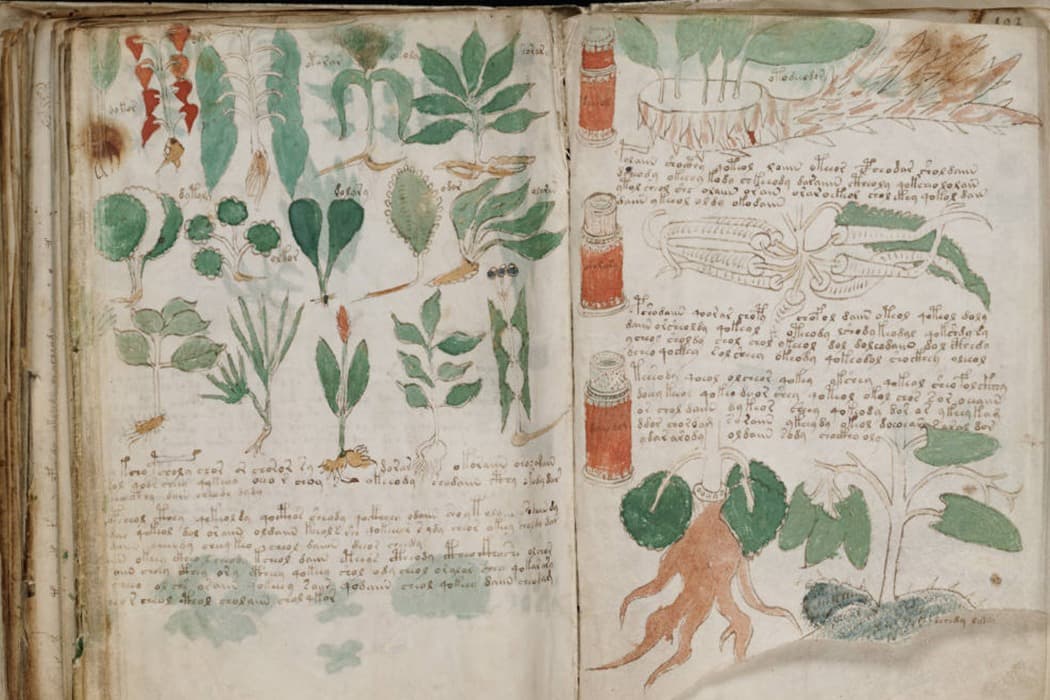 Le manuscrit de Voynich, datant du XVe siècle. Source de la photo : The Paris Review
En 2018, Kondrak et le chercheur Bradley Hauer ont utilisé le traitement du langage naturel (NLP) pour analyser le célèbre manuscrit de Voynich, datant du XVe siècle, et ont identifié l’hébreu comme sa langue sous-jacente la plus probable. Par la suite, son équipe a appliqué des modèles algorithmiques au « Dorabella Cipher » d’Edward Elgar, datant de 1897, et a découvert qu’il s’agissait davantage d’une notation musicale que d’un texte, révélant ainsi une mélodie cachée et jouable.
Véritables « copilotes » intelligents aux côtés des historiens, ces modèles d’IA mettent en évidence des tendances à travers des millions de caractères, ouvrant ainsi de nouvelles perspectives sur des siècles de pensée humaine.
Recherche : faire progresser la science de l'IA
Restez informé
Inscrivez-vous pour recevoir régulièrement des mises à jour par e-mail de la part d'Amii, notamment des actualités et des événements, de nouveaux épisodes de podcast, des mises à jour sur les recherches, et bien plus encore. Vous pouvez modifier vos préférences en matière d'e-mails ou vous désabonner à tout moment.